Table of contents
Open Table of contents
데이터 정규화란
데이터 정규화(Normalization)는 모델 학습 이전에 여러 Feature 데이터 값의 범위를 조정하는 과정을 말하며, Feature Scaling 또는 Data Scaling이라고 부른다.
데이터 값의 범위 차이가 클 경우, 아래의 그림 1 좌측처럼 비효율적인 최적화 과정을 거치게 된다.
데이터 간 편차가 큰 Feature 위주로 학습이 진행되기 때문에 x축 방향 위주로 파라미터가 갱신되며 최적화가 진행된다.
반면, 상대적으로 편차가 적은 y축 방향의 Feature의 영향력은 상대적으로 무시되는 현상이 발생한다.
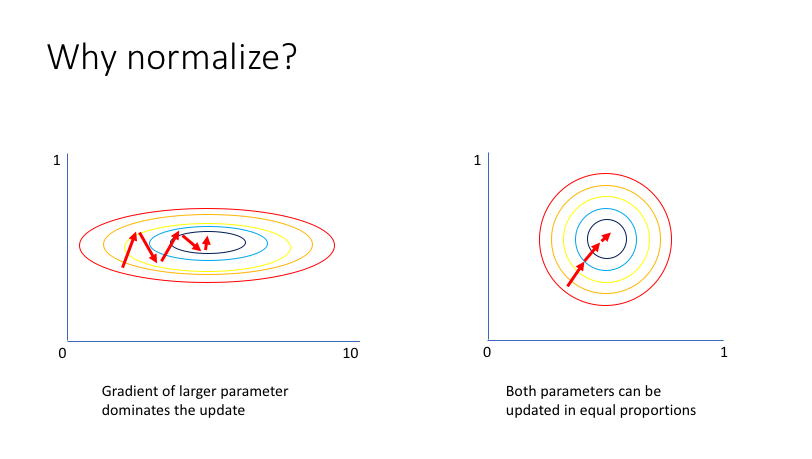
데이터를 정규화하게 되면 위의 문제점을 해결할 수 있다.
즉, 그림 1 우측처럼, 데이터 범위의 차이가 작아지기 때문에, 모델 학습 시 모든 Feature마다 파라미터가 유사한 중요도를 갖고 개선되기 때문에 최적화 과정이 개선되는 효과가 있다.
Internal Covariate Shift 현상
모델 학습 전에 입력 Feature 간 데이터 범위를 조정할 수 있지만, 모델 학습 과정에서 Layer를 통과할 때마다 출력값의 데이터 분포는 Layer마다 다르게 나타나는 현상이 있다.
이러한 현상을 Internal Covariate Shift(ICS)라고 부른다.
Internal Covariate Shift(ICS)는 모델이 학습 과정에서 Layer마다 입력 데이터의 분포가 변하는 현상이다.
예를 들어, 아래의 그림 2처럼, 첫 번째 Layer를 통과한 후 출력이자 2번째 Layer의 입력 데이터의 분포는 Gausian 분포를 따르지만, 2번째 Layer의 출력과 3번째 Layer의 출력 데이터의 분포는 한쪽으로 치우치게 나타나는 경우이다.
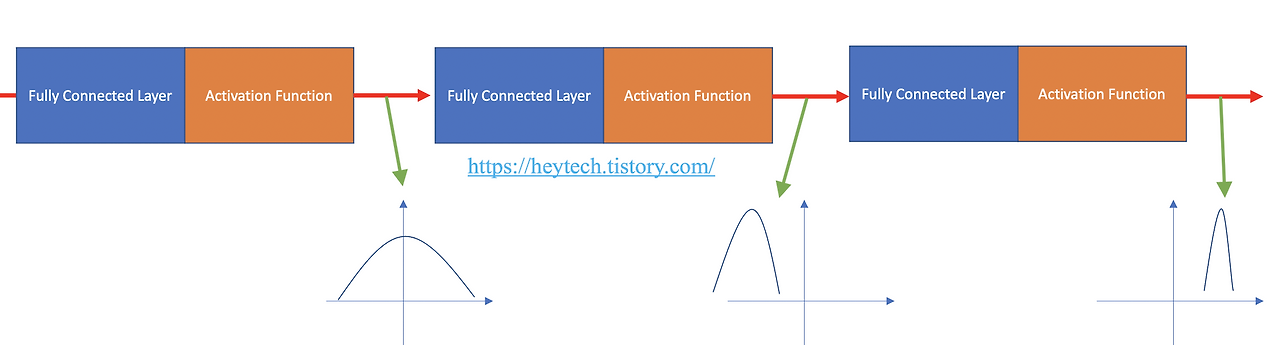
하지만 Layer마다 동일한 학습률(Learning Rate)로 학습할 때, Internal Covariate Shift 현상으로 데이터 분포가 Layer마다 다를 경우 학습 성능이 떨어지는 문제가 발생한다.
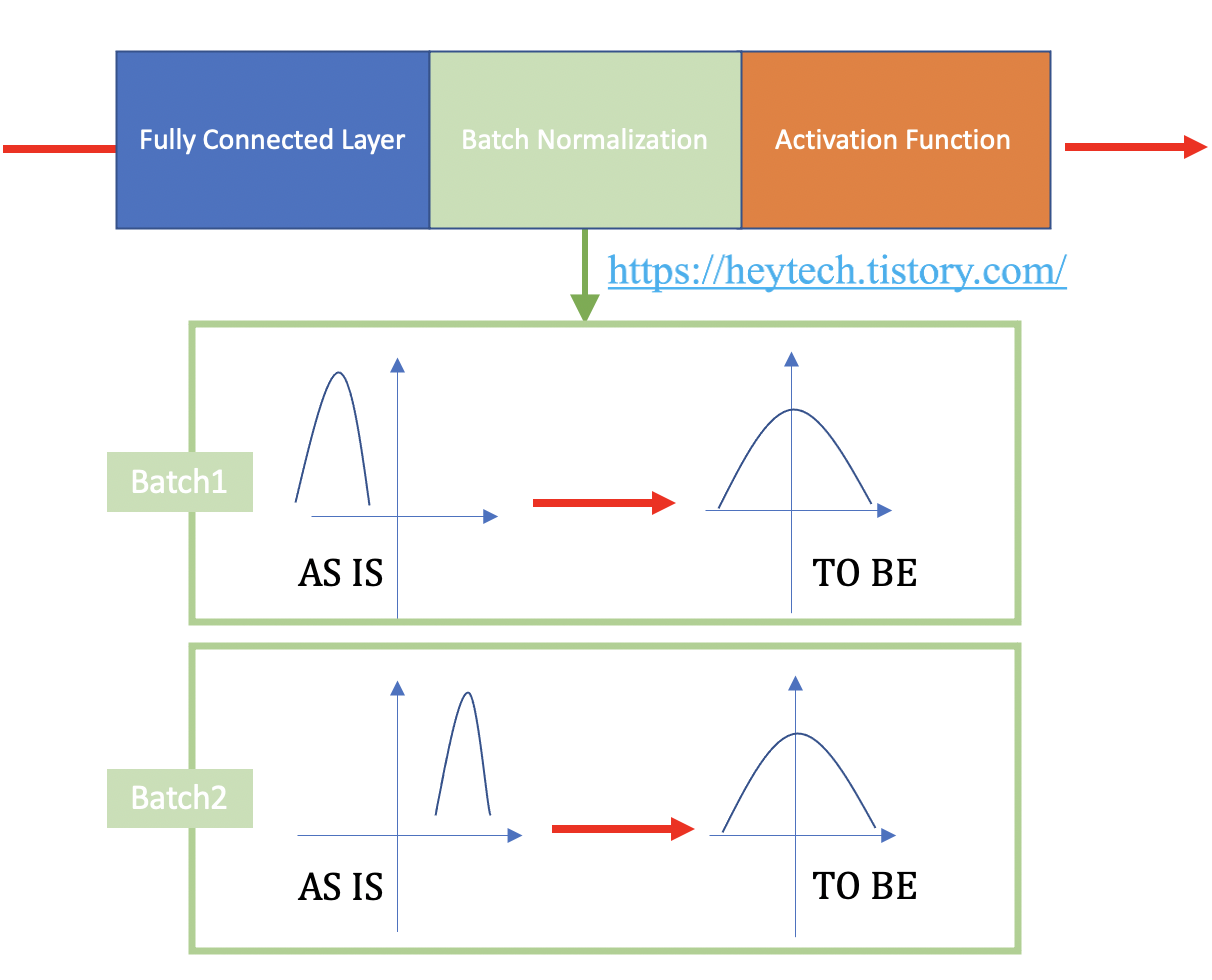
특히, Mini Batch 학습법 사용 시 Batch마다 출력 데이터의 분포가 다르게 나타나고, 이는 전혀 예측 불가한 Gradient를 학습하게 되어 학습의 질이 떨어지는 문제가 발생한다.
Batch Normalization
배치 정규화(Batch Normalization)는 학습 과정에서 Batch마다 평균과 분산을 활용하여 데이터의 분포를 정규화하는 과정을 말한다.
데이터 종류에 따라 값의 범위는 천차만별이기 때문에, Batch마다 입력값의 범위를 스케일링하는 과정이 바로 Batch Normalization이다.
배치 정규화의 장점
데이터 Scale 통일
어떠한 데이터 분포가 입력으로 들어와도 모두 정규화하기 때문에 모든 Layer의 Feature가 동일한 Scale이 되도록 만드는 점이다.
즉, 앞서 살펴본 Batch마다 데이터 분포가 달라지는 Internal Covariate Shift 현상을 방지할 수 있고 학습률 결정 시 효과적이다.
모델 학습 과정에는 손실함수(Loss Function)와 가까운 Layer일수록 학습이 잘 되고, 멀리 있는 Layer일수록 학습이 잘 안 되는 특징이 있다.
즉, 손실함수에 멀리 있는 Layer일수록 학습률을 높게 설정하는 것처럼, 일반적으로 학습 성능을 올리기 위해서는 Layer마다 학습률을 다르게 설정할 필요가 있다.
하지만, Batch Normalization을 사용할 경우 모든 Layer의 Feature마다 동일한 scale이 되기 때문에 학습률을 결정하는 데 도움이 된다.
참고 https://heytech.tistory.com/438