Table of contents
Open Table of contents
확산 모델 (Diffusion Model)
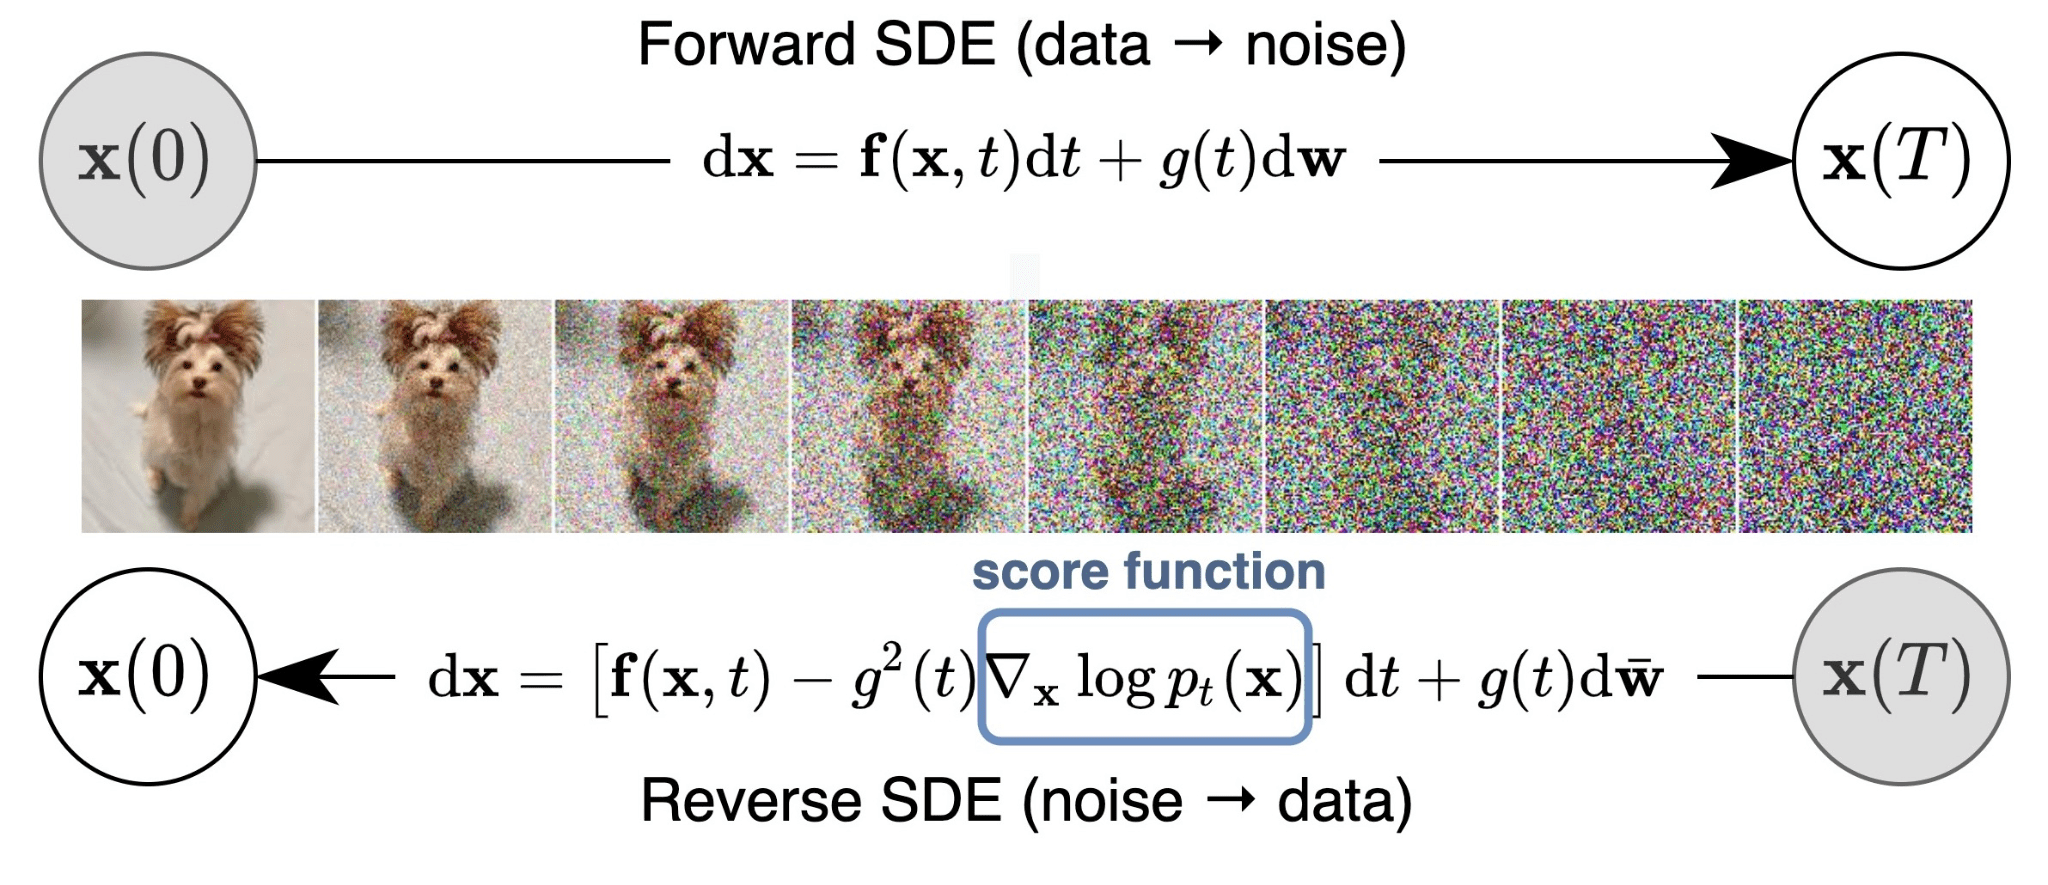
확산 모델은 사후 분포(posterior distribution)를 활용하여 데이터를 생성하는 확률적인 방법이다.
높은 차원의 데이터에서 특히 이미지 데이터를 생성하는데 주로 사용된다.
확산 모델의 핵심 아이디어는 반복적으로 데이터의 확률 분포를 확산시키는 것으로, 이미지의 각 픽셀 값을 조건부로 예측하는데 사용한다.
작동원리
- 확산 모델은 어떤 초기 이미지 또는 노이즈를 사용하여 시작한다.
- 그런 다음 픽셀 값을 확률적으로 예측한다. 각 픽셀의 값은 이전 픽셀들과 함께 이용되어 예측된다.
- 이렇게 확산을 반복하면서 이미지의 픽셀 값을 조금씩 조정해가며, 생성된 이미지가 점차적으로 실제 데이터와 유사해지도록 만든다.
GAN (Generative Adversarial Network)
GAN은 생성자(Generator)와 판별자(Discriminator) 두 개의 신경망으로 구성되는 생성 모델이다.
생성자는 실제 데이터와 유사한 가짜 데이터를 생성하려고 하고, 판별자는 생성자로부터 생성된 데이터와 실제 데이터를 구별하려고 한다.
이 두 신경망이 서로 경쟁하면서 학습하게되는데, 이것이 Adversarial(적대적)한 학습의 기반이 된다.
작동원리
- 생성자는 무작위 노이즈 벡터를 입력으로 받아 가짜 데이터를 생성한다.
- 판별자는 실제 데이터와 생성자로부터 생성된 가짜 데이터를 구별하여 실제 데이터와 가짜 데이터를 구분하는데 사용된다.
- 생성자는 판별자를 속이기 위해 점점 더 실제 데이터와 유사한 가짜 데이터를 생성하려고 노력한다.
- 판별자는 생성자의 노력에 따라 실제 데이터와 가짜 데이터를 더 잘 구별하도록 학습한다.
- 이러한 경쟁과 학습이 지속되면서 생성자는 실제 데이터와 매우 유사한 데이터를 생성할 수 있게 되고, 판별자는 더욱 정확하게 데이터를 구분할 수 있게 된다.

차이점
- 확산 모델은 확률적인 방법을 사용하여 데이터를 생성하는 반면, GAN은 경쟁과 학습을 통해 데이터를 생성한다.
- 확산 모델은 이미지의 픽셀 값을 조건부로 예측하여 생성하는 반면, GAN은 무작위 노이즈 벡터를 입력으로 받아 가짜 데이터를 생성한다.
- 확산 모델은 픽셀 값을 확률 분포를 확산시키는 과정을 반복하면서 생성을 수행하지만, GAN은 생성자와 판별자 간의 경쟁을 통해 데이터를 점진적으로 개선시킨다.
이러한 원리와 차이점으로 인해 확산 모델과 GAN은 각자의 장단점과 특징을 가지고 있다.
선택하는 모델은 사용하고자 하는 문제와 데이터에 따라 달라질 수 있다.